
前面兩天我們處理了 Model、QNN、HTP。
到這裡看起來好像事情差不多完成了。
但實際跑起來,我們很快發現:
NPU 快,不代表整個 AI Application 快。
因為一張影像從 Camera 到 Event,中間其實還有很多事情。
RTSP
 ↓
Decode
 ↓
Pre-processing
 ↓
QNN / HTP
 ↓
Post-processing
 ↓
Rule
 ↓
Event
真正要優化的不是只有 Inference,而是整條 End-to-End Pipeline。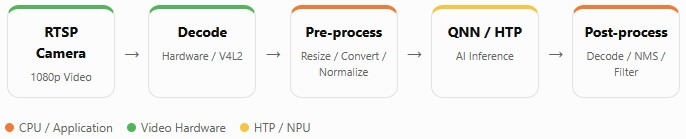
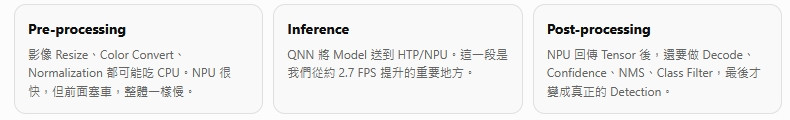
Camera 進來是 1080p,但 Model 可能只吃 640×640。
所以中間還要做:
Resize
Color Convert
Normalize
Tensor Convert
如果這些全部丟給 CPU,NPU 再快也沒用。
這一段就是 Qualcomm HTP/NPU 發揮的地方:
Input Tensor
     ↓
QNN
     ↓
HTP
     ↓
Output Tensor
這也是我們看到 2.7 FPS → 約 31 FPS 主要的加速來源。
但 NPU 出來的不是「Person」。
它通常是一堆 Tensor。
我們還要繼續處理:
Tensor
 ↓
Decode
 ↓
Confidence Filter
 ↓
NMS
 ↓
Class Filter
 ↓
Bounding Box
最後才知道:
這裡有一個 Person。
再往後才是我們產品自己的:
Person
 ↓
Geofence
 ↓
Intrusion
 ↓
Event
 ↓
Alert
所以這一天我開始把效能問題換一個方式看:
不要只看 Model FPS,要看整條 End-to-End Pipeline。
NPU 只是其中一段。
真正的 Edge AI Product,是:
Video → AI → Rule → Event
每一段都有可能成為 Bottleneck。
而下一個問題就很直接了:
如果一支 Camera 可以跑,那兩支、三支呢?


 iThome鐵人賽
 看影片追技術